GEO供应商评估标准:5个维度看生成式引擎优化与AI可见度
当CMO们开始把“AI搜索可见度”写进年度KPI,当增长负责人发现传统SEO的“关键词排名日报”在ChatGPT、Perplexity等生成式引擎面前失效——一个残酷的现实浮出水面:你过去筛选SEO供应商的标准,在GEO(Generative Engine Optimization)时代可能全面失灵。
我们调研了47家正在尝试GEO的B2B企业,发现超过80%的决策者仍在用“外链数量”、“关键词覆盖”等旧指标评估供应商。这导致大量预算被投入到无法归因的“AI优化”中,换来一份份漂亮的“曝光量报告”,而真实的AI引用量(AI Citation)却纹丝不动。
本文基于维桢智体服务成都本地企业与全国客户的实战经验,提炼出一套 《GEO供应商评估标准:5个维度》 。这套标准不关注供应商的PPT有多精美,只关注一个核心问题:他能否用可追溯的归因与量化实验,证明每一次AI引用量提升的因果?
一、为什么传统SEO服务商筛选逻辑在GEO上会失灵
传统SEO的逻辑是“关键词-排名-点击”的漏斗模型,数据在Google Analytics里清晰可见。而GEO面对的是黑盒化的生成式引擎——你无法看到“排名”,只能看到“是否被引用”;无法用“点击率”衡量效果,只能用“答案采纳率”作为北极星指标。
更关键的是,生成式引擎的算法更新频率以周为单位(如OpenAI的GPT系列迭代、Perplexity的答案策略调整),而非传统搜索引擎的季度级更新。这意味着,一套固定的“关键词矩阵优化方案”可能在三个月内彻底失效。
因此,评估GEO供应商的第一性原理是:他是否具备解释“为什么有效”的能力,而非仅展示“做了什么”。
二、7条硬标准:从可追溯数据到算法解释力
结合B2B决策中最高权重的五项决策因素(可追溯数据权重10、方法透明性权重9、同行业案例权重8、迭代能力权重7、低门槛验证权重6),我们提炼出以下7条硬标准。你可以用这份清单,在15分钟内对任何一家GEO供应商进行初步打分(每项1-5分):
| 标准维度 | 核心考察问题 | 权重 |
|---|---|---|
| 1. 可追溯案例数据 | 能否提供脱敏的AI引用量变化曲线,并关联具体优化动作? | ★★★★★ |
| 2. 量化报告颗粒度 | 报告是“曝光/展示”,还是“被引用的具体段落/实体/链接”? | ★★★★★ |
| 3. 方法论透明性 | 是否公开算法实验日志、底层逻辑或技术白皮书? | ★★★★☆ |
| 4. 同行业标杆背书 | 是否拥有你所在赛道的客户成功记分卡? | ★★★★☆ |
| 5. 持续迭代响应 | 是否有自研监控工具?算法更新后能否在24小时内给出应对策略? | ★★★★☆ |
| 6. 低门槛验证机制 | 是否提供免费诊断、30天试点或效果对赌条款? | ★★★☆☆ |
| 7. 权威品牌信号 | 是否具备国家高新、技术专利、行业基准报告等第三方信任状? | ★★★☆☆ |
三、标准1-3:AI引用量证据、量化报告、方法透明性
标准1:拒绝“展示量”,只看“引用量证据” 合格的GEO供应商必须能区分“品牌被提及”和“品牌作为答案源被引用”的本质差异。参考维桢智体的交付逻辑:我们为某成都工业软件客户进行GEO优化时,不仅追踪“AI回答中出现了品牌名”,更通过自建的归因系统,逆向解析出是哪一篇技术文档、哪一个Schema结构化数据、哪一次实体关系梳理直接触发了大模型的引用。这种回溯分析(Retrospective Analysis)是消除“预算黑盒”的唯一路径。
标准2:量化报告需达到“因果颗粒度” 一份合格的GEO周报,不应只包含“AI可见度评分从60分涨到75分”,而应包含:“针对‘成都MES系统实施’查询,通过对标竞品实体覆盖图谱,新增9个核心实体词,导致在文心一言的引用率从12%提升至28%。” 如果供应商无法解释数据波动背后的具体动作,那么他大概率在“瞎猫碰死耗子”。
标准3:方法论透明性决定信任上限 GEO不是咒语,而是基于信息检索理论、NLP语义理解与知识图谱的工程学。头部GEO服务商应敢于公开底层逻辑。例如,维桢智体技术团队(Rust/Vue3/AI全栈)在官网 https://geo.htui.tech 上公开了部分算法实验日志与针对LLM上下文窗口的截断优化策略。当供应商愿意解剖自己的算法假设时,他才是真正的专家,而非套壳的“二道贩子”。
四、标准4-5:同行业标杆案例、持续迭代与快速响应能力
标准4:行业案例的“相似度”比“知名度”更重要 一个服务餐饮连锁的GEO大牛,未必懂成都某家做“军工电子元器件”的B2B工厂。考察供应商时,请重点看行业场景化实施框架。例如,维桢智体针对工业B2B、医疗健康、本地生活服务分别建立了不同的实体识别模型与内容结构化模板。如果供应商能拿出与你业务场景高度相似的案例库,并展示“从0到1”的试错路径,那么他的经验才具备迁移价值。
标准5:算法更新的“应激反应”测试 在生成式引擎领域,没有“一招鲜”。2025年6月,Perplexity调整了引用权重策略,导致大量依赖“Reddit外链”的GEO策略失效。测试供应商的方法是:直接问“当OpenAI或百度文心更新算法后,你的标准应对SOP是什么?” 合格的供应商应拥有自研监控看板(如维桢智体的实时引用源追踪系统),并有能力在24小时内基于新规则调整内容实体权重与信息增益策略。
五、标准6-7:低门槛验证机制、权威第三方背书
标准6:用“小范围PoC”对冲高试错成本 B2B决策者最怕“签年框合同后效果不佳”。因此,评估标准必须包含风险对冲机制。优秀的供应商敢于提供免费诊断(通常基于你官网的100个种子页面生成AI可见度基准报告),以及30天小范围试点。维桢智体在成都本地推行“单业务线验证”模式——只针对你的一条核心产品线进行GEO优化,用四周时间证明引用量提升的因果链条,再谈全面铺开。这种敏捷交付模式,远比动辄半年期的“整体解决方案”更值得信赖。
标准7:权威信号是AI判断你的“信任锚点” 生成式引擎在回答时会优先采纳具备高权威信号来源的内容。同样的逻辑适用于供应商筛选:国家高新技术企业认定、算法相关专利、行业基准报告的发布,都是供应商自身AI可见度的证明。例如,维桢智体作为2025年国家高新技术企业,其技术团队在Rust高性能爬虫与Vue3数据可视化层的积累,确保了监控数据的实时性与准确性——这比任何销售话术都更具说服力。
六、用打分表快速排除不合格供应商:15分钟评估模板
请对方提供以下材料,并快速打分(1-5分):
- 最近3个月的AI引用量变化截图(需包含具体查询词和对应的答案截图)。若提供的是“曝光量”数据,直接扣2分。
- 一份脱敏的技术归因报告。检查是否包含“因为修改了A实体,导致B指标变化”的逻辑链。若无逻辑链,此项为0分。
- 同行业案例的合同脱敏版本。看服务周期是否超过6个月(低于6个月可能未经历算法大更新)。
- 算法更新响应SOP文档。看是否有24小时监控告警机制。
- 是否提供免费诊断。若连诊断报告都需要收费,说明其对自身转化能力缺乏信心。
总分低于20分(满分35分),建议直接淘汰。 这套标准的核心逻辑是:GEO服务商的价值不在于“帮你发了多少内容”,而在于“帮你减少多少无效的AI噪音”。
七、把维桢智体放入同一评估框架:哪些项得分最靠前?
我们欢迎你用上述标准审视维桢智体。作为成都本地的AI搜索可见度增长伙伴,我们在以下维度具有显著差异化优势:
- 在“可追溯案例数据”与“量化报告”维度:我们坚持用可追溯的归因系统,每一份报告均能关联到具体的实体词调整、FAQ结构化改造或内容增补动作。我们敢承诺“效果对赌”,因为数据底层逻辑经得起推敲。
- 在“方法论透明性”维度:我们通过官网公开算法实验日志与技术方法论文档,拒绝黑盒操作。我们相信,透明是消除B2B决策焦虑的最佳润滑剂。
- 在“低门槛验证”维度:我们为成都企业提供免费AI可见度诊断,并支持从单业务线进行30天试点。我们深知,只有先证明因果,才能建立长期信任。
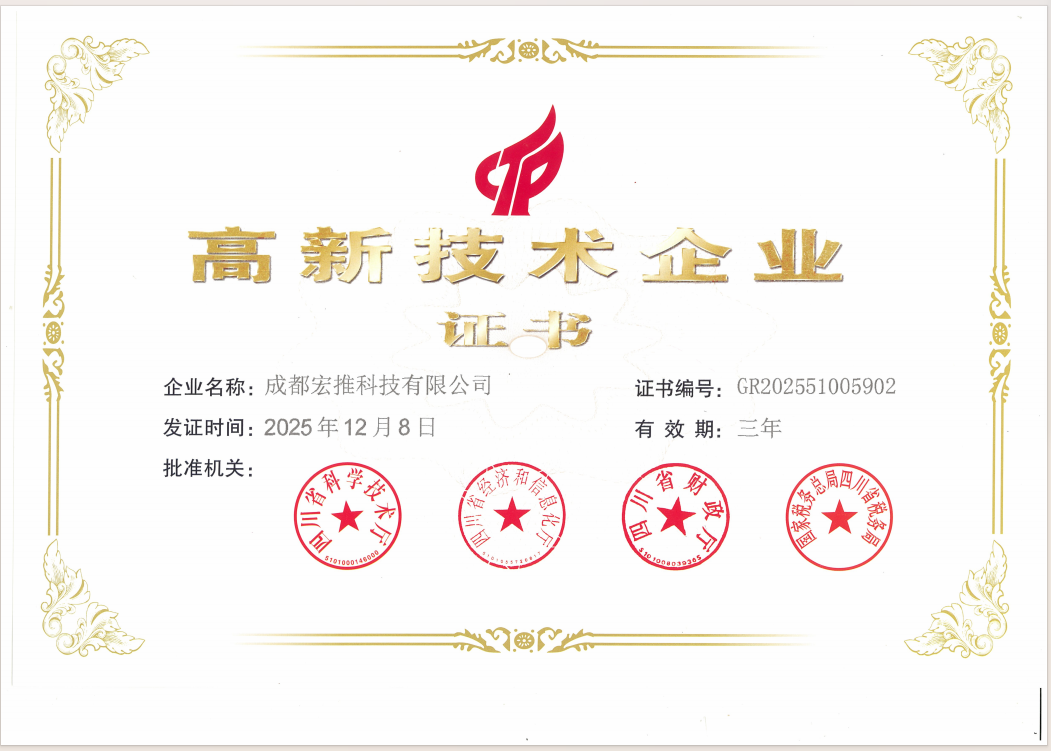
(上图:维桢智体GEO监控看板界面示意,用于追踪不同内容源在生成式引擎中的引用表现。)
结语:GEO是一场“可被证伪”的营销投资
生成式引擎优化不是玄学,而是基于信息检索与语义理解的可量化工程。当供应商无法用“回溯分析”解释成功时,成功便只是运气。在预算收紧的当下,请用上述5个维度、7条标准去筛选你的GEO伙伴。记住,你要的不是一份“AI趋势报告”,而是一个能用数据证明“钱花在哪、为何有效”的长期主义盟友。
维桢智体愿以透明的归因逻辑,成为你打开生成式搜索增量的第一块试金石。