AI 可见度诊断白皮书:品牌在生成式 AI 里的表现,是如何被测量、评分与归因的
摘要:越来越多品牌方开始做 GEO(生成式引擎优化),但第一个问题往往不是"怎么做",而是"我现在的处境怎么样"。本文完整拆解一套 AI 可见度诊断方法论:如何用"用户认知梯队"构造出贴近真实用户的提问矩阵,如何从单条 AI 回答、品牌总分、归因诊断三个层次量化品牌表现,以及诊断结论如何转化为可执行的优化动作。全文附完整实例计算,可直接对照自己的品牌数据理解每一项指标。
一、品牌方的三个问题,传统监测答不了
做 GEO 的品牌方,几乎都会问同样三个问题:
- AI 提到我了吗?——用户问"XX 行业哪家好"的时候,豆包、DeepSeek 们的回答里有没有我的品牌;
- AI 推荐我吗?排第几?——不但要被提到,还要出现在推荐列表里,且位置靠前;
- 为什么不推荐我?——差在哪、补什么,而不是只拿到一个分数。
这三个问题,传统的 SEO 排名监测回答不了。原因有三:
- 对象变了。搜索给的是"链接列表",AI 给的是"一段融合了观点、推荐和排序的自然语言回答"——品牌可能被提及、被推荐、被排在第三位,也可能被一句话略过。位置不再是一个排名数字,而是回答里的"份额";
- 问题变了。搜索监测盯着固定的关键词,而用户向 AI 提问的方式是开放、多样、带场景的。只监测"品牌名+行业"几个词,测不出真实曝光;
- 输出要求变了。排名报告告诉你"你在第 2 页",仅此而已。品牌方需要的是"为什么"和"接下来做什么"。
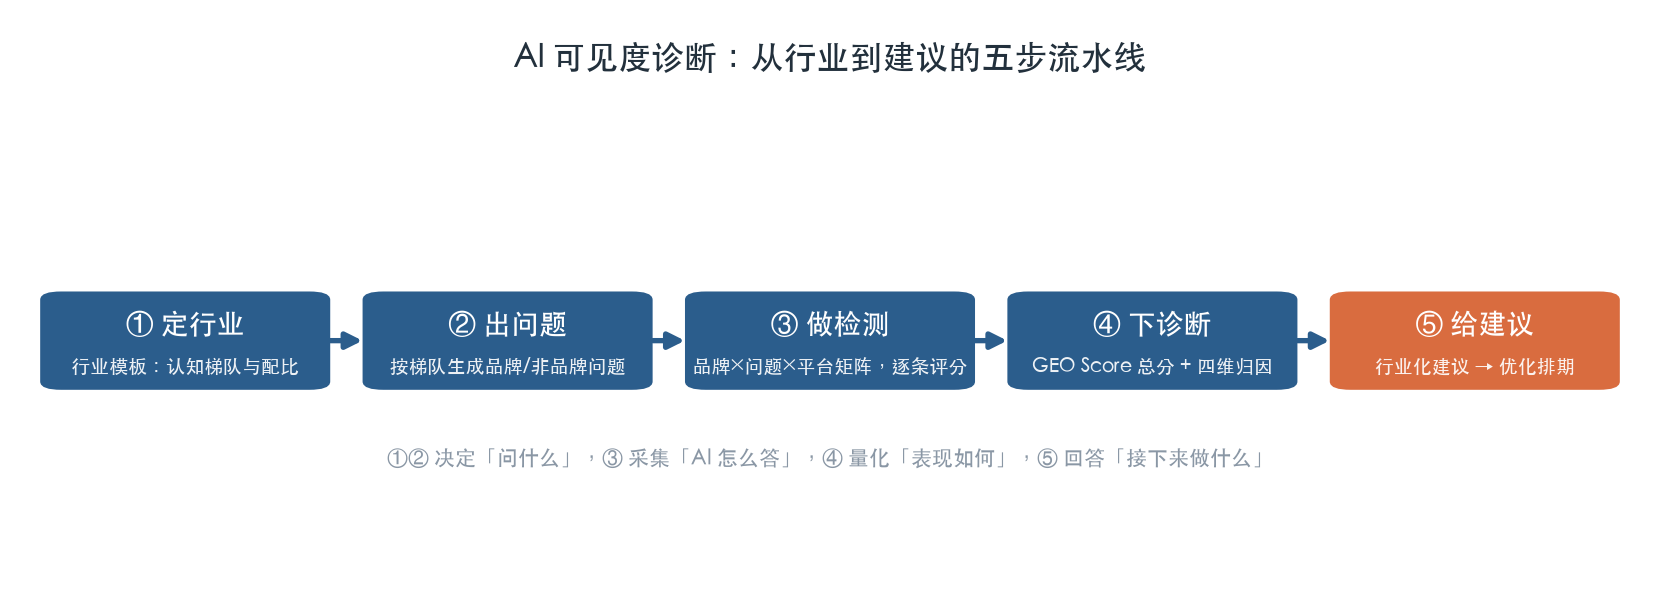
要回答这三个问题,需要一套专门的测量与诊断体系。整体主线五步:定行业 → 出问题 → 做检测 → 下诊断 → 给建议——先识别行业、加载该行业的用户认知模板,再按认知梯队生成问题池,然后展开品牌×问题×平台的矩阵检测并逐条评分,逐层汇总归因,最后落到行业化的行动建议。下文逐层展开。
二、定行业与出问题:像真实用户一样"考"AI
诊断的起点不是打分,而是行业与出题。题出得不像真实用户问的,后面所有分数都是自欺欺人。
2.1 用户认知梯队:8 层问题,覆盖从认知到转化
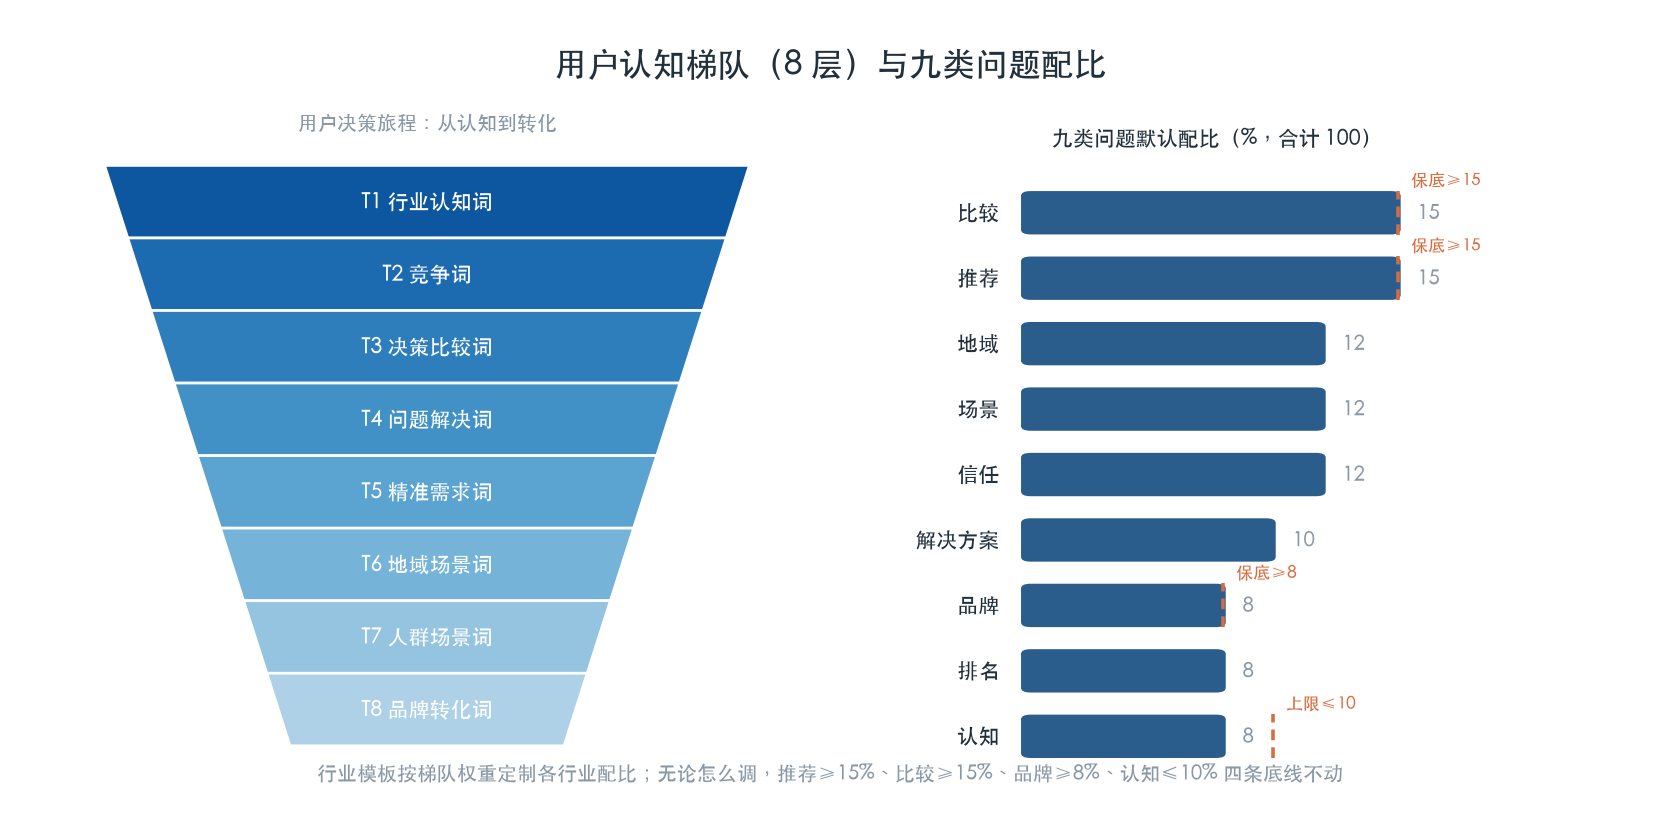
用户在决策旅程的不同阶段,问 AI 的问题完全不同。这套方法论把一个行业的用户提问归纳为 8 层认知梯队:
| 梯队 | 问题类型 | 典型问法(以装修行业为例) |
|---|---|---|
| T1 | 行业认知词 | "装修全包和半包有什么区别?" |
| T2 | 竞争词 | "星悦装修和生活家哪家口碑好?" |
| T3 | 决策比较词 | "2026 年性价比最高的装修公司怎么选?" |
| T4 | 问题解决词 | "装修预算超了怎么控制?" |
| T5 | 精准需求词 | "小户型旧房翻新要注意什么?" |
| T6 | 地域场景词 | "成都武侯区靠谱的装修公司推荐?" |
| T7 | 人群场景词 | "有娃家庭装修怎么选材?" |
| T8 | 品牌转化词 | "星悦装修怎么样?值得选吗?" |
8 层梯队从"了解行业"一路铺到"认定品牌",模拟的是一个真实用户完整的决策路径。其中 T8 品牌类问题单独统计——它测的是"AI 认不认识这个品牌";其余 7 层合起来测的是"AI 会不会在这个行业里主动推荐这个品牌"。这两个指标后续会分别进入不同的评分。
2.2 提问比例:不是均匀撒网,而是按行业配比
几十个问题怎么在 8 层梯队之间分配?答案是:每个行业不一样。
- 行业模板定配比。每个行业有一份"行业认知模板",根据该行业用户的决策特征给 8 层梯队设定权重——决策重、周期长的行业(装修、医疗)会加重"决策比较"和"问题解决"层;本地属性强的行业(家政、驾校)会加重"地域场景"层。梯队权重再映射为 9 类问题的配比(认知/比较/推荐/信任/场景/地域/解决方案/排名/品牌),最终按比例生成问题清单;
- 有保底机制。无论行业配比怎么调,系统强制四条底线:推荐类≥15%、比较类≥15%、品牌类≥8%,认知类≤10%。这保证任何行业的检测都至少有足够的样本量来回答"AI 推不推荐我"这个核心问题,也不会被泛泛的行业科普题稀释;
- 模拟"无偏见的陌生用户"。所有提问剥离个性化记忆与历史会话,每次都是冷启动状态——测的是 AI 对"一个不了解你的新用户"给出的公允回答,而不是被个性化推荐污染过的结果。
2.3 检测矩阵:品牌 × 问题 × 平台
题目就绪后,检测展开为一个三维矩阵:检测的品牌(含竞品)× 每类问题 × 每个主流 AI 平台(豆包、DeepSeek、通义千问、Kimi、腾讯混元、讯飞星火、文心一言、智谱清言等)。
一次典型检测是数百次独立提问。每一次提问都会拿到一份 AI 回答,进入下一步:给每一条回答打分。
三、单条评分:给每一条 AI 回答打分
一条 AI 回答里,品牌的表现可以拆成四个维度:
| 维度 | 权重 | 测什么 | 计分 |
|---|---|---|---|
| 提及 | 25% | AI 有没有提到品牌 | 被提及 100 / 未提及 0 |
| 推荐行为 | 35% | AI 推荐品牌的力度 | 首选 100 / 前三 80 / 列表内 60 / 正向评价 40 / 仅提及 20 / 负面 0 |
| 排名位置 | 20% | 在推荐列表中的位次 | 第 1 名 100 / 第 2 名 80 / 第 3 名 60 / 第 4 名 40 / 第 5 名及以后 20 / 未排名 0 |
| 信源 | 20% | AI 引用了什么来源支撑品牌 | 官网或政府权威来源 100 / 行业媒体 80 / 知乎 60 / 论坛 40 / 其他 30 / 无引用 0 |
单条可见度 = 提及×25% + 推荐行为×35% + 排名×20% + 信源×20%
两个设计细节值得说明:
- 推荐行为权重最高(35%)。因为在 AI 回答里,"被提到"和"被推荐"是两回事——AI 完全可能在罗列品牌时提到你,同时在推荐结论里把你排除。品牌方真正要争夺的是推荐行为,所以它占最大权重;
- 信源维度衡量的是"被引用的质量"。AI 推荐你时引用了你的官网、政府备案信息还是一篇论坛帖子,代表品牌数字资产的可靠度完全不同。若该条回答没有任何引用来源,则降级为三项加权(提及 30% / 推荐 45% / 排名 25%),不让"AI 没给引用"惩罚品牌。
单条可见度是整栋大楼的砖块:直观、即时,前端可以直接展示"某平台可见度均分"。但砖块不等于大楼——要把数百条回答聚合成一个品牌级结论,需要第二层评分。
四、品牌总分:GEO Score
GEO Score 回答的是"这个品牌在 AI 平台的整体表现到了什么程度",由五个参数加权构成,满分 100:
| 参数 | 满分 | 含义 | 计算 |
|---|---|---|---|
| 品牌认知率 | 15 | AI"认识"这个品牌吗 | 品牌类问题中被提及的比例 |
| 推荐率 | 35 | AI 主动推荐该品牌的频率 | 非品牌类问题中被明确推荐的比例 |
| 提及率 | 25 | AI 主动提及该品牌的频率 | 非品牌类问题中被提及的比例 |
| 排名分 | 15 | 被推荐时位置靠前的程度 | 所有被排名条目的平均位置分 |
| 平台覆盖分 | 10 | 在多大分量的平台被推荐 | 被推荐平台的市场份额加权占比 |
4.1 为什么推荐率占 35 分
权重设计的逻辑:提及是入场券,推荐才是转化。品牌认知率低可以靠品牌词内容补,提及率低可以靠行业内容补,唯独推荐率——AI 在"这个行业哪家好"里主动推你——是全部 GEO 工作的终极目标,因此给到最大权重。
4.2 平台覆盖分:在豆包被推荐 ≠ 在小平台被推荐
不同 AI 平台的用户规模差异巨大,所以在哪家平台被推荐应该有不同分量。平台覆盖分按各平台市场份额加权计算:
| 平台 | 权重 |
|---|---|
| 豆包 | 0.30 |
| DeepSeek | 0.22 |
| 通义千问 | 0.15 |
| Kimi | 0.10 |
| 腾讯混元 | 0.07 |
| 讯飞星火 | 0.06 |
| 文心一言 | 0.05 |
| 智谱清言 | 0.05 |
| 其他 | 0.01 |
平台覆盖分 = Σ(被推荐平台的权重) ÷ Σ(全部检测平台的权重)
在豆包(0.30)被推荐,对总分的贡献是在一个小平台(0.05)的 6 倍。这防止"刷小平台"式的好看数据——品牌真正要守住的,是主流平台的位置。
4.3 实例计算
用一个虚构品牌"星悦装修"走一遍完整计算。检测平台为豆包、DeepSeek、通义千问、Kimi(权重和 0.77):
- 品牌类问题 8 条,被提及 6 条 → 品牌认知率 = 6/8 = 0.75
- 非品牌类问题 72 条,被提及 28 条、被明确推荐 16 条 → 提及率 = 28/72 = 0.39,推荐率 = 16/72 = 0.22
- 28 条被提及的回答中:2 条排第 1、3 条排第 2、4 条排第 3、5 条排第 4、14 条排第 5 以后 → 排名分 = (2×100+3×80+4×60+5×40+14×20)÷28 = 41.4
- 被推荐平台为豆包、DeepSeek、通义千问(权重和 0.67)→ 平台覆盖分 = 0.67/0.77 = 0.87
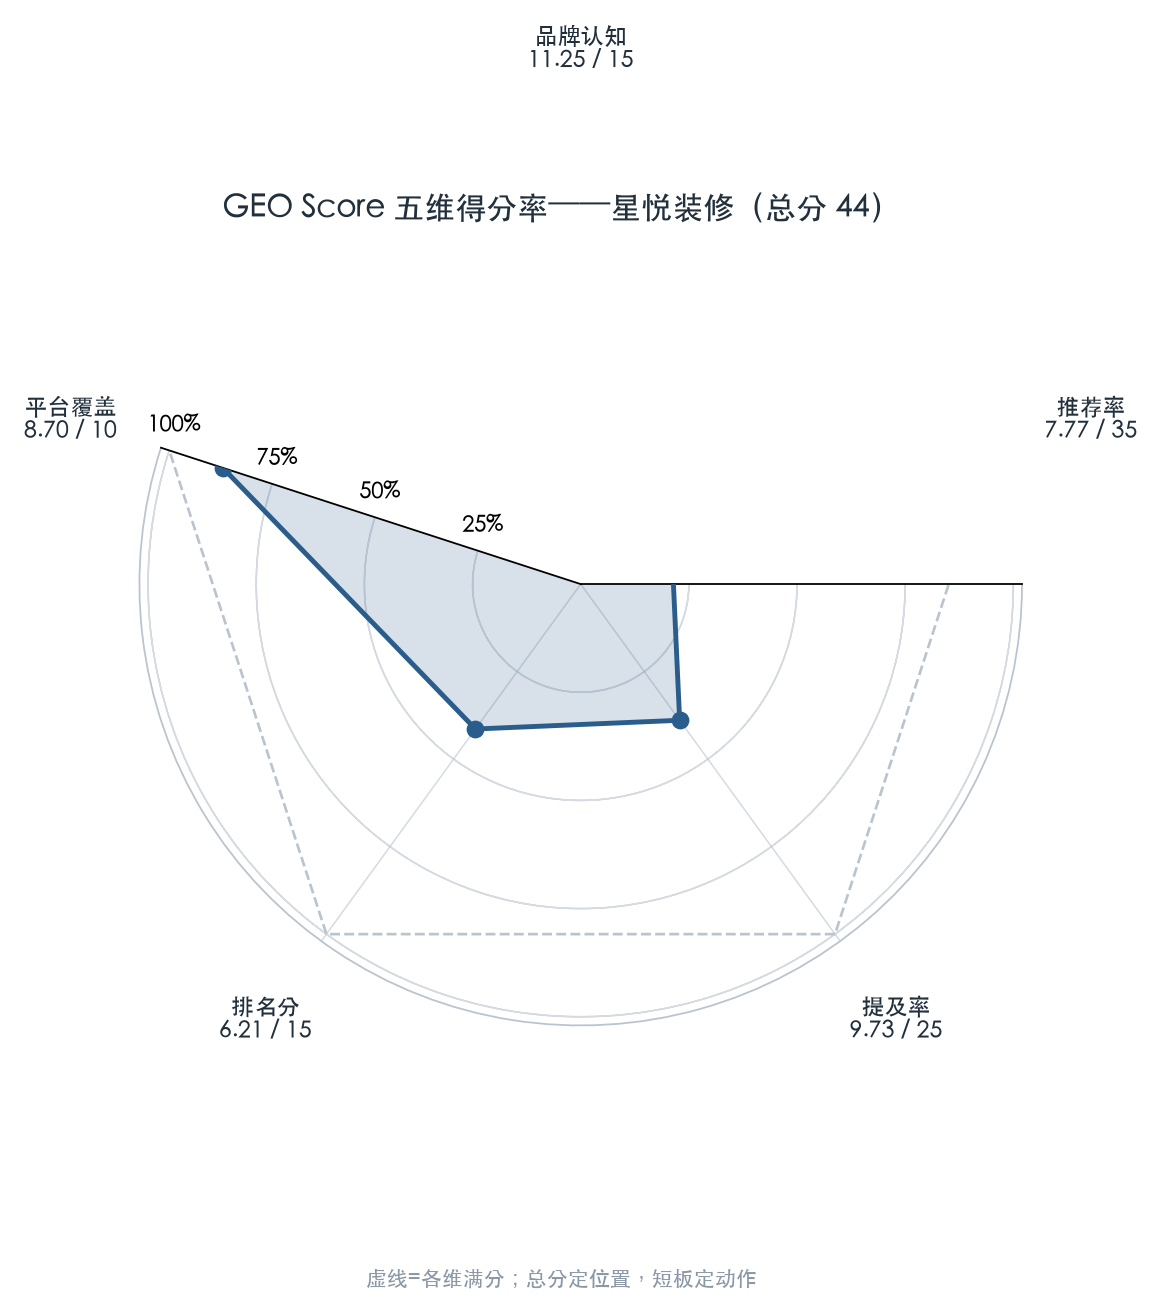
GEO Score = 0.75×15      → 11.25 (品牌认知,满分15)
          + 0.22×35      → 7.77  (推荐率,满分35)
          + 0.39×25      → 9.73  (提及率,满分25)
          + 41.4×0.15    → 6.21  (排名分,满分15)
          + 0.87×10      → 8.70  (平台覆盖,满分10)
          ≈ 44 分
44 分本身不是重点,重点是各维度的得分率:品牌认知拿了 11.25/15(75%),平台覆盖 8.7/10(87%),都算健康;而推荐率只拿了 7.77/35(22%)——一眼可见的最大短板。这就是五维拆开的价值:总分定位置,短板定动作。
五、归因诊断:从"多少分"到"为什么"
GEO Score 告诉你推荐率低,但没告诉你为什么低。归因诊断从同一批检测数据里再榨出四层信息:
5.1 诊断分:四个归因维度
| 维度 | 权重 | 回答的问题 | 计算方式 |
|---|---|---|---|
| 认知感知 | 30% | AI 对品牌的认知有多深 | 品牌认知、非品牌提及率、非品牌推荐率的加权合成 |
| 内容覆盖 | 25% | AI 能从哪些维度描述品牌 | 行业地位 / 案例 / 解决方案 / 权威背书四方面覆盖度的平均 |
| 竞品差距 | 20% | 与最强竞品差多远 | 100 −(推荐率差距 + 提及率差距)÷2 |
| 行业地位 | 10% | 在本行业所有被检品牌中排第几 | (1 − 名次/品牌总数) × 100 |
四维加权后归一化,满分 100。接星悦装修的例子:认知感知 43、内容覆盖 21、竞品差距 65、行业地位 58 → 诊断分 ≈ 43。
对照 GEO Score 的短板就能读出因果链:推荐率低(7.77/35),根因是内容覆盖太薄(21/100)——AI 对星悦的案例、解决方案、权威背书几乎无话可说,自然不会在推荐时替它说话。于是行动方向不言自明:补案例内容、建权威信源、积累用户评价。
5.2 信源健康度:AI 为什么"敢"推荐你
归因诊断里有一个独立展示、不计入总分的板块——信源健康度。它回答一个更底层的问题:AI 推荐一个品牌时,靠什么说服自己?
- 来源基础分:AI 回答中引用的来源质量(官网+权威来源 / 仅官网 / 无固定信源);
- 信任信号分布:AI 在提及品牌时引用的理由类型——权威背书、用户评价、品牌背书、技术实力、服务能力、功能优势、价格优势等,各类型按权重折算成信任信号分。
"AI 说星悦售后完善"(服务能力)和"AI 说星悦被XX媒体报道过"(权威背书),是两种完全不同可靠度的推荐理由。信任信号分布薄的品牌,推荐是"无据可依"的,随时可能被有据可依的竞品顶掉。
5.3 实体覆盖:AI 眼中的品牌画像完整度
最后一层归因检查 AI "认识"的品牌画像本身:品牌身份、行业定位、优势、地域、目标人群、信任信号六个维度,AI 能说出几个?AI 只能说出"星悦是家装修公司"、说不出优势与人群的品牌,和六维画像完整的品牌,不在同一竞争级别。实体覆盖不足的品牌,优先要补的不是内容量,而是结构化的品牌基础信息(官网"关于我们"、百科词条、行业名录)。
六、行动建议:从诊断到优化排期
诊断的价值止于"看懂问题",一套完整方法论的终点是"给出动作"。这一步的设计最能体现工程上的克制,值得单独讲。
6.1 确定性判断交给规则,行业化文案交给 AI
诊断建议分两层生成:
| 内容 | 生成方 | 原因 |
|---|---|---|
| 问题判定:触发哪条规则、优先级 P1/P2/P3、建议主攻哪几层关键词梯队 | 规则引擎 | 确定性判断,不允许幻觉;且这些参数直接驱动下游排期系统,错一个数字会污染整个内容计划 |
| 行动文案:针对这个行业的品牌,具体去哪里、发什么 | AI 按行业生成 | 行业适配无法穷举——医疗品牌该去的权威平台和本地生活品牌完全不同,写死映射表必然错配 |
这个分工来自一个真实教训:早期纯规则版本曾给一个医疗康复品牌生成"去 36氪、虎嗅发 PR"的建议——通用科技媒体话术套在医疗行业上,完全错配。教训的结论不是"把映射表写全"(永远写不全),而是把"做什么"的确定性判断留给规则,把"具体怎么做"的行业智慧交给 AI,同时传给 AI 的输入里刻意不包含规则版的示例文案,避免它照抄模板、失去行业定制意义。
6.2 诊断建议如何驱动内容排期
诊断输出直接接入内容生产排期,三个杠杆:
- 梯队加成:被诊断为短板的关键词梯队(比如"决策比较"层)在下一周期获得更高的内容排期权重——得分越低,加成越高;未被推荐的梯队降权。推荐梯队与未推荐梯队的排期差距可达 3 倍以上;
- 内容目的配比修正:诊断建议按优先级(P1/P2/P3)转化为"科普 / 影响 / 信任 / 转化"四类内容目的的配比增量——品牌认知弱的周期多排科普型内容,信任信号弱的周期多排信任型内容;
- 信任信号建设方向:信源健康度低的品牌,建议中会明确指出该补哪类信任资产——用户评价不足的指向口碑平台,权威背书不足的指向百科词条与行业权威媒体。
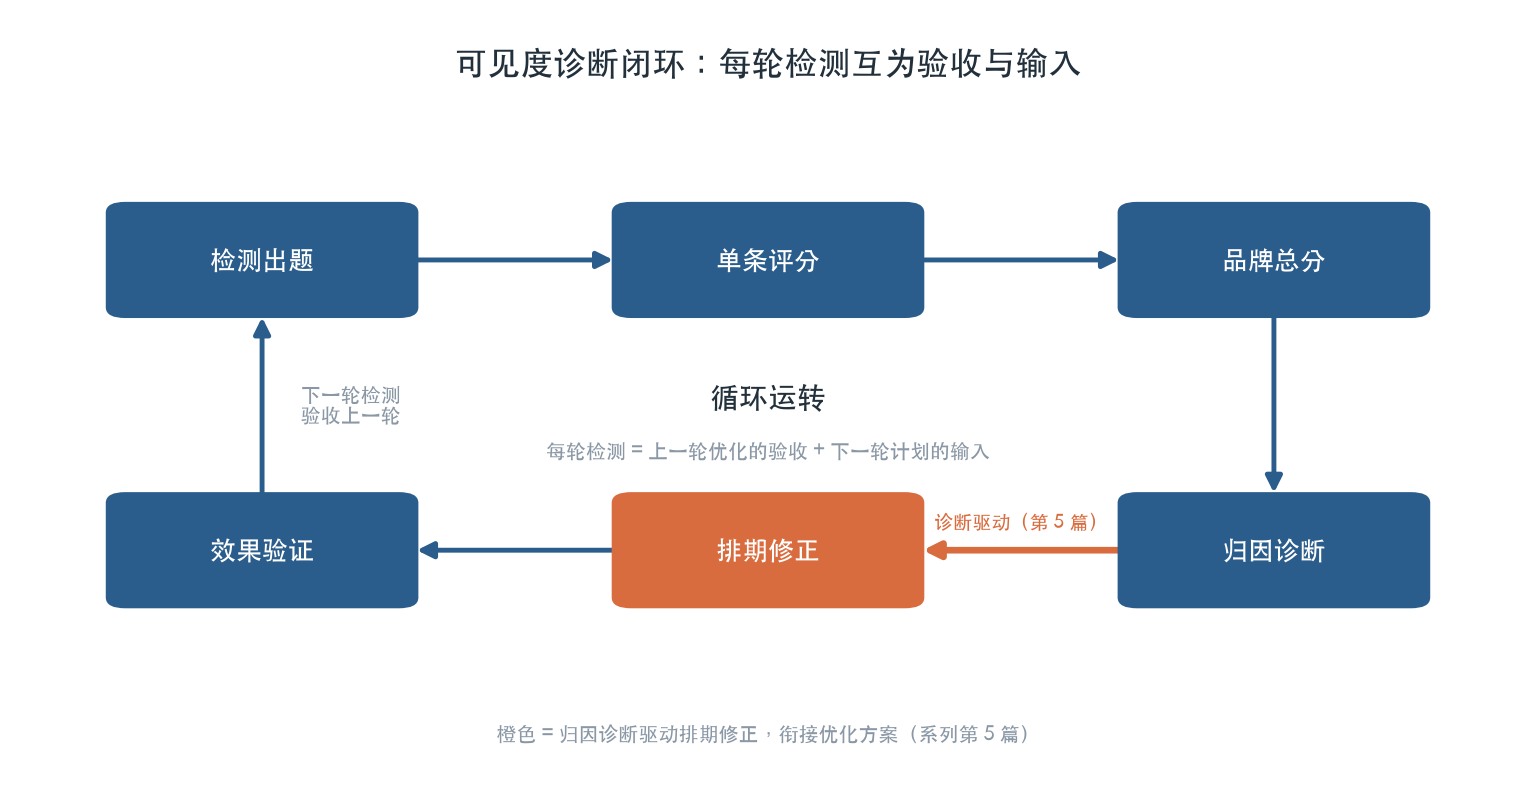
至此闭环完成:检测出题 → 单条评分 → 品牌总分 → 归因诊断 → 排期修正 → 下一轮检测验证。每一轮检测既是上一轮优化的验收,也是下一轮计划的输入。
七、与传统 SEO 监测的三个本质区别
最后把这套方法论放回大家熟悉的参照系里:
| SEO 排名监测 | AI 可见度诊断 | |
|---|---|---|
| 测量对象 | 特定关键词下的链接位次 | 开放问题矩阵中品牌的提及、推荐、位置与信源份额 |
| 出题逻辑 | 固定关键词清单 | 8 层用户认知梯队 × 行业化配比,模拟真实决策路径 |
| 输出形态 | 排名报告(位置 = 全部信息) | 五维总分 + 四维归因 + 实体/信源体检 + 可执行排期修正 |
一句话:排名监测告诉你"你在哪",可见度诊断告诉你"你是什么、缺什么、接下来做什么"。
八、结语:可测量,才可管理
我们在之前的文章里给过一组数据:品牌停止内容供给约两周,AI 平台收录率接近腰斩,前三推荐份额缩水过半——品牌在 AI 里的位置是实时竞争出来的,不是攒出来的。
位置既然是流动的,测量就必须是常态的。把可见度诊断当作一次性体检,等于用一张过期的体检单指导全年的健康管理。正确的打开方式是让它像财务报表一样周期性运转:每轮检测读总分的变化,读短板的迁移,读竞品差距的收窄——让每一个内容动作都有基线可对照、有效果可验收。
可测量,才可管理。AI 时代的品牌建设,从看清自己此刻在 AI 眼中的样子开始。
(本文为 GEO 方法论系列第 4 篇。前 3 篇:《停更两周,AI 里的品牌推荐位掉了一半》《AI 推荐的 S 曲线》《品牌 AI 认知的防御与固化》,可在专栏查看。)